COMFYUI 基礎 · 第 13 課
沿著輪廓生成:第一次載入 Qwen Union Control LoRA
用官方圖片和原生 Canny 節點,把輪廓送進 Qwen-Image;核對底模、三條 latent 分支,再比較 LoRA 強度 1、0.5、0。附官方原始檔、三份攤平工作流與觀察單。
開始前,準備這些
- 已有可開啟且具備本課原生節點的 ComfyUI,能載入 JSON 和上傳圖片
- 理解固定 seed;先閱讀本課底模差異與磁碟容量
- 能自行確認設備可承受本課模型;無設備者可先讀圖,不需購買服務
這一課,你會學會
- 核對 Qwen-Image 20B 與 Union LoRA 的相容組合
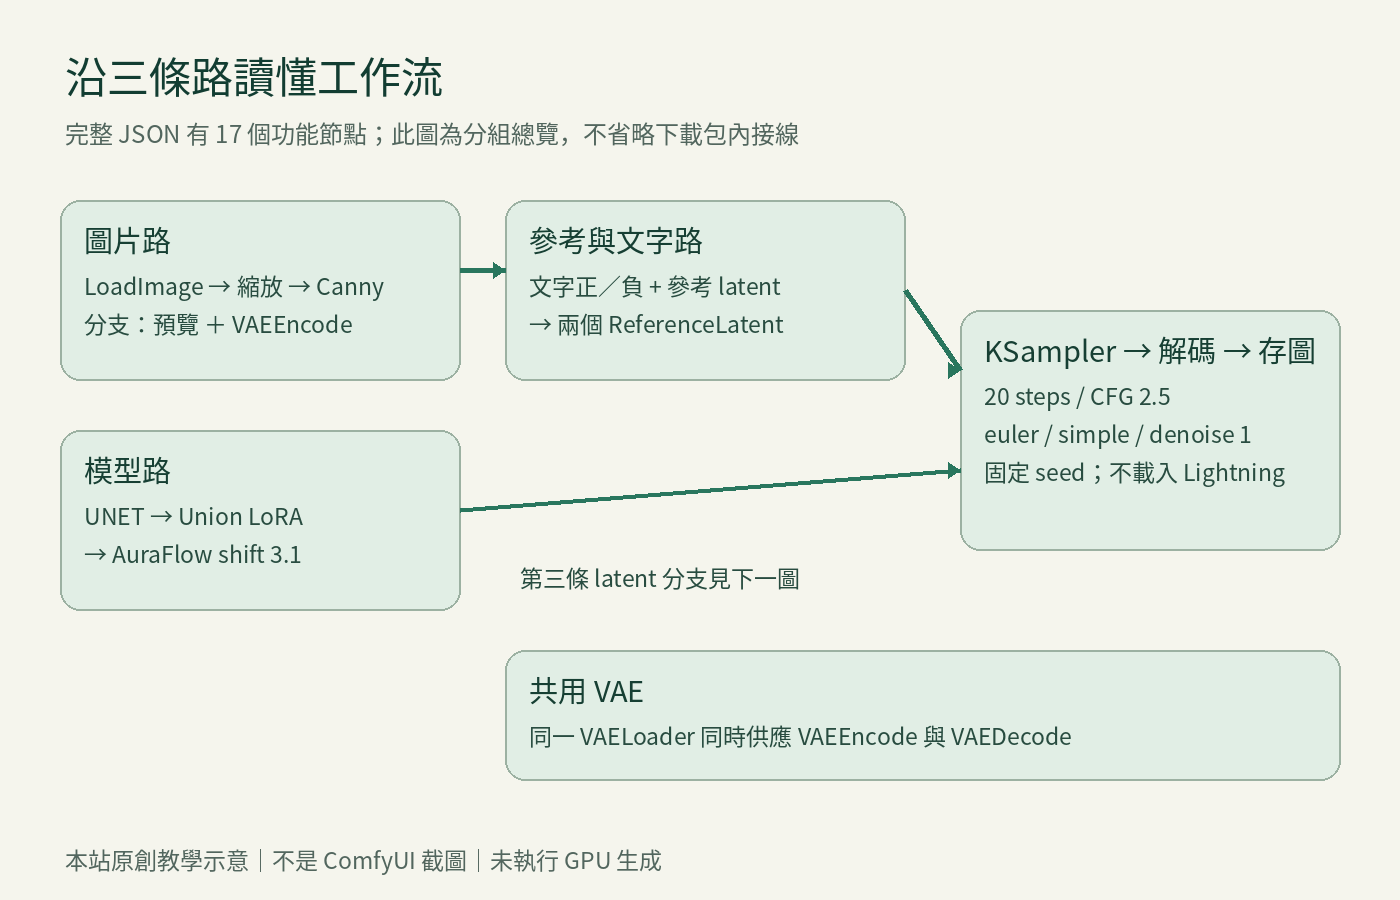
- 接好 Canny、VAEEncode 與三條 latent 分支
- 保存三份只改 LoRA 強度的實測紀錄,不把消融對照誤認為純文字生圖
本課目錄
先停一下:這一課換了底模
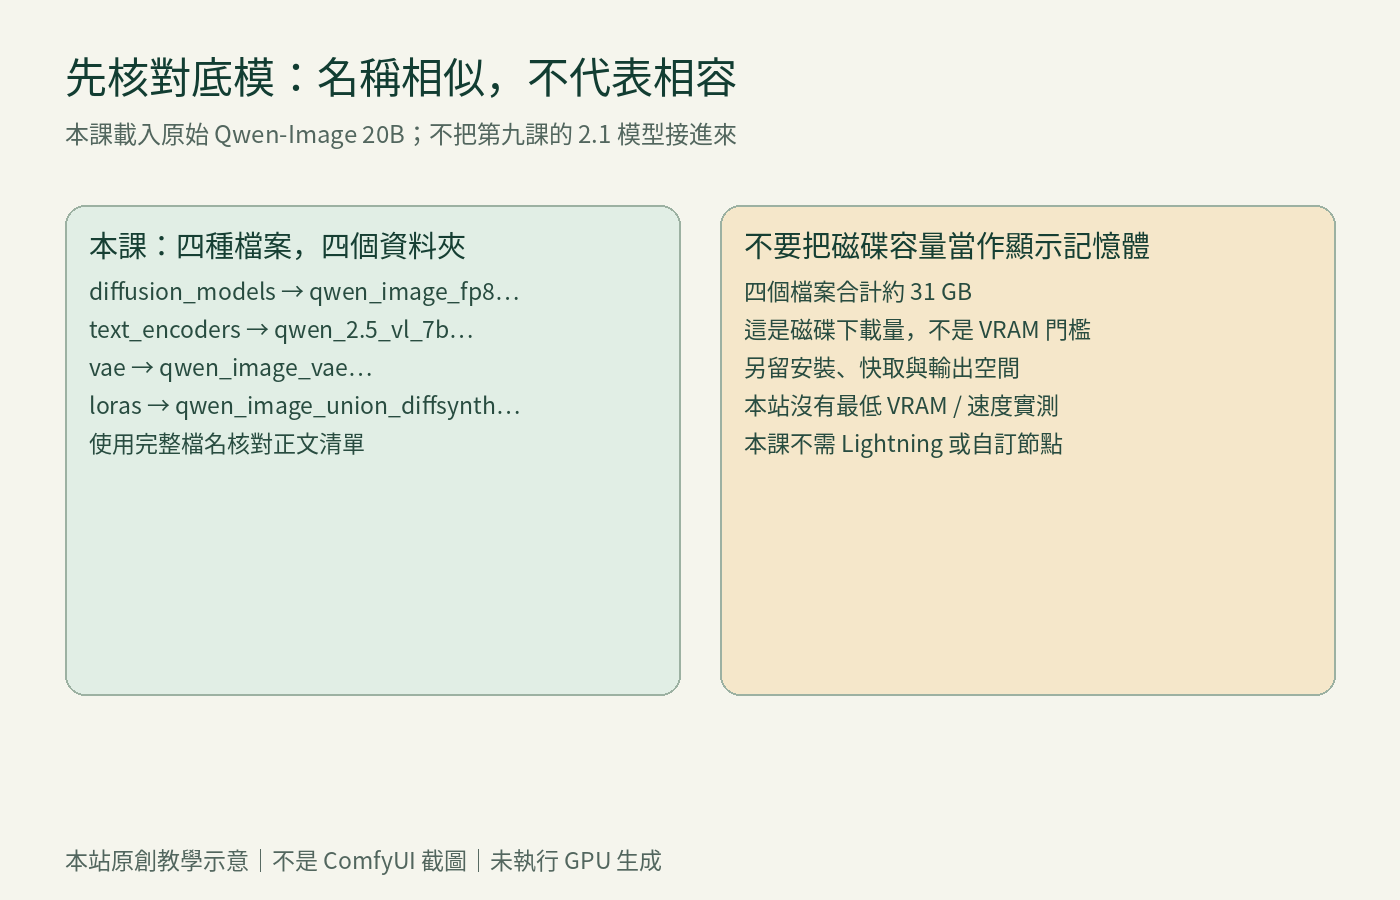
本課使用原始 Qwen-Image 20B,不是第九課的 Qwen-Image-2.1,也不是 Qwen-Image-Edit。請勿把 Union LoRA 直接接到第九課的 2.1 模型。 名稱相近、檔案都是 safetensors,不代表權重相容。
四個模型檔案的下載量合計約 31 GB,這是磁碟容量,不是 VRAM 需求。請另外保留安裝、快取及輸出空間。本站未實測此流程的最低 VRAM、生成速度或你的硬體;不能用檔案大小推算一定跑得動。若目前設備不適合,先完成讀圖與接線檢查即可。
這課新增的是「結構引導」:先從圖片取出邊緣,再用 Union Control LoRA 讓生成過程參考輪廓。LoRA 是對底模的附加權重;它不是完整底模,也不是保證逐像素複製的濾鏡。輪廓約束有助於構圖,但不保證人物身分、衣服細節或每片花瓣完全一致。官方流程說明
驗證邊界: 下面兩張人物圖是 Comfy Org 公開的輸入與示範輸出,已下載原始位元組並解碼查看。其他四張圖是本站原創接線/操作示意,不是 ComfyUI 截圖,也不是本站生成成果。下載包已做靜態連線核對,仍未匯入 ComfyUI GUI、未做 GPU 推論。A/B/C 的好壞由你的實測決定,不能把官方一張示範圖當成我們已跑完三組。
第 0 步:下載練習包,先看這次要學什麼
下載第十三課練習包 ZIP,解壓縮到新的資料夾。模型權重不在包內;先備份你原本的工作流,再開始本課。
- lesson-13-A.json/B.json/C.json:攤平的17節點練習流程,沒有子工作流,也沒有 Lightning 分支
- official-union-control.json:固定版本官方原始 JSON,保留子工作流與選用加速分支,供進階核對
- official-input.png:真正要在 Load Image 裡上傳的輸入圖片
- official-output.png:官方結果範例,只供觀察,不能冒充自己跑出的結果
- observations.csv:三列狀態預填 not_run;實際成功才改 success,失敗填 failed
- README.txt、LICENSE-Comfy-Org.txt、media-sources.json:操作提醒、原始授權、來源及檔案雜湊
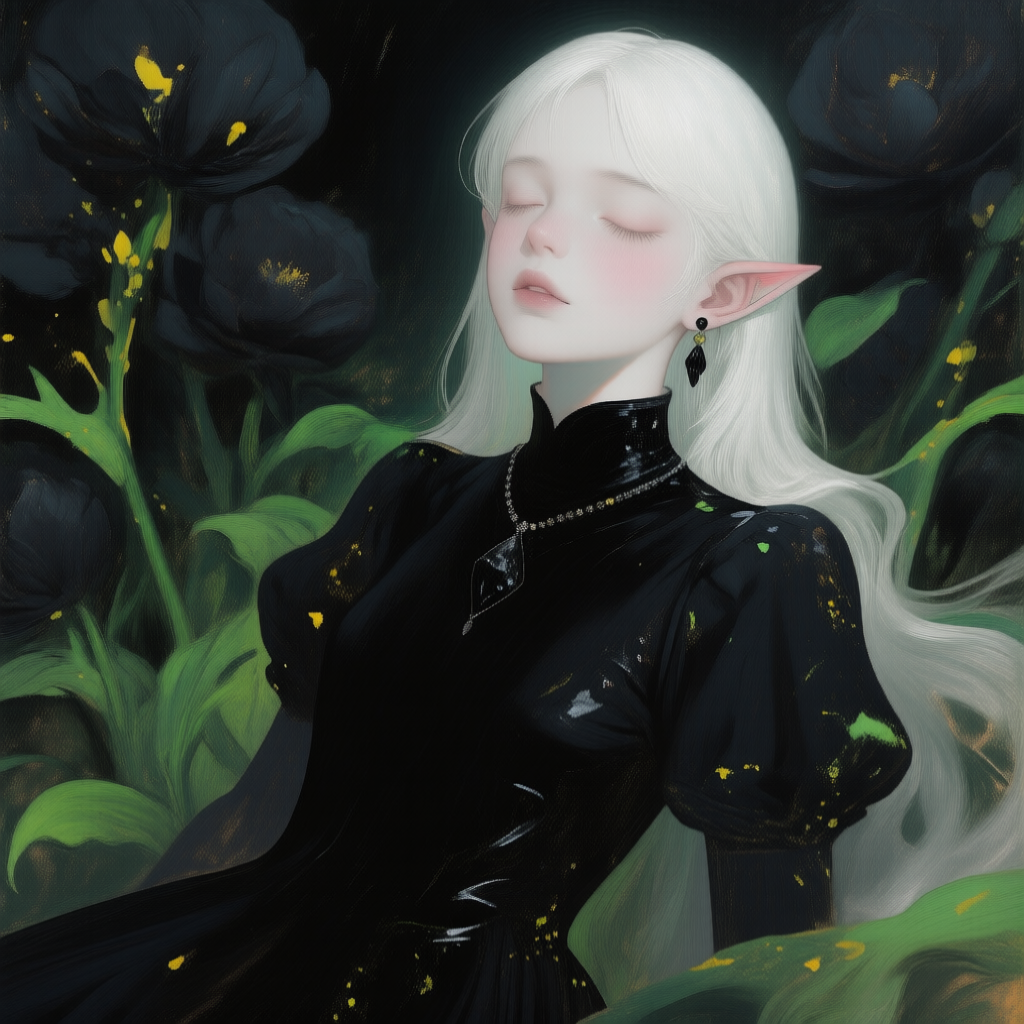
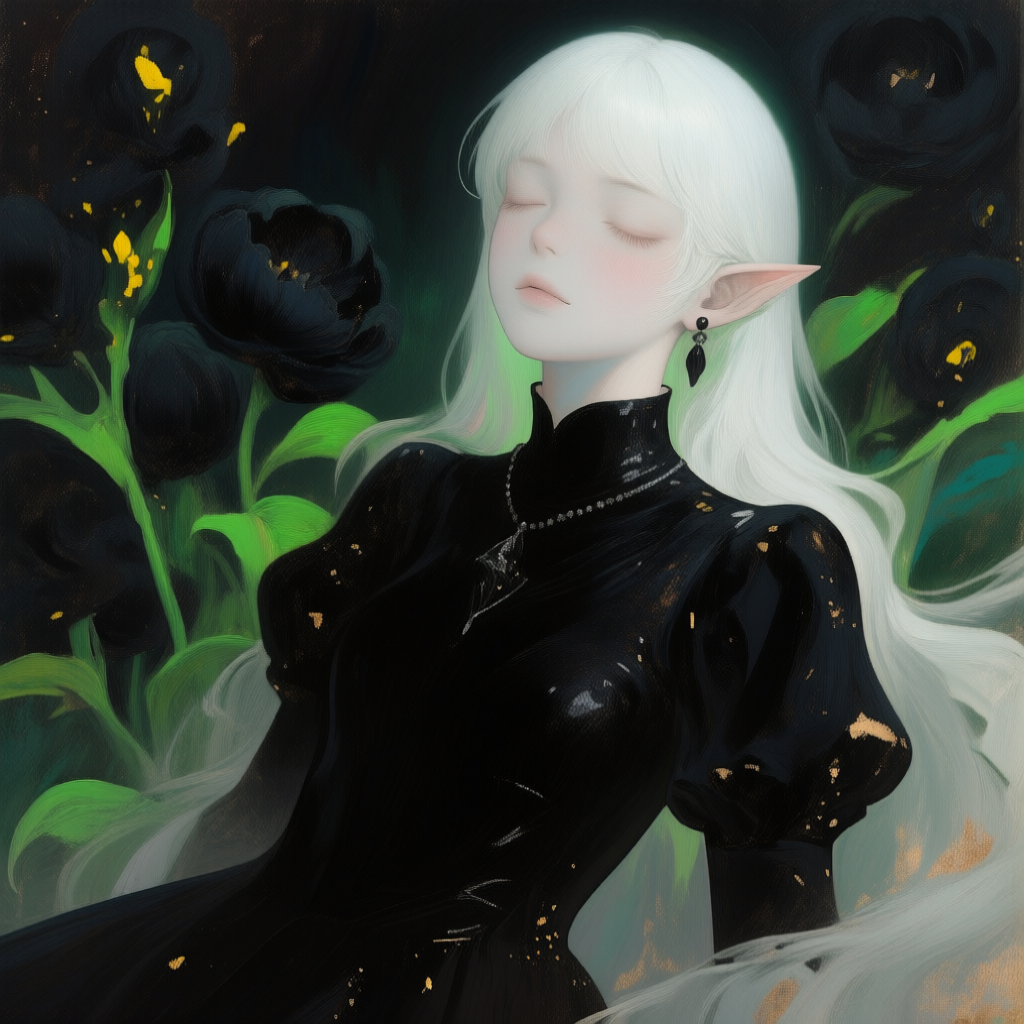
上傳圖片,不要拖圖恢復流程: 兩張官方 PNG 都帶有 prompt、workflow 中繼資料。輸入圖內嵌的是較舊流程,包含不同的 Canny 門檻與 LoRA 檔名。這課要先用 Open 開 lesson-13-A.json,再於 Load Image 的上傳按鈕選 official-input.png;不要拖輸入 PNG 到畫布還原它的舊流程。中繼資料分享原理可回看第十二課。
第 1 步:四個模型,各放進對的資料夾
只從以下官方模型頁核對下載,完整檔名請照清單。模型 repo 標示 Apache-2.0;使用前閱讀所連模型頁及授權。模型授權不代表你取得任意人物、品牌或第三方素材的權利。
| 檔案與官方入口 | 放在 ComfyUI/models/ 下 | 檔案頁約略大小 |
|---|---|---|
| qwen_image_fp8_e4m3fn.safetensors | diffusion_models/ | 20.4 GB |
| qwen_2.5_vl_7b_fp8_scaled.safetensors | text_encoders/ | 9.38 GB |
| qwen_image_vae.safetensors | vae/ | 254 MB |
| qwen_image_union_diffsynth_lora.safetensors | loras/ | 944 MB |
以上使用檔案頁的十進位近似值,不混用模板註解的容量單位。不是下載31 GB後再額外下載一個完整模型包;這四個就是本課主線所需的檔案。若已有完全相同檔名且來源可信的檔案,不必重複下載。不要因為第九課有另一個 Qwen 模型就直接替換。
- 檔案放好後重新整理模型清單;若仍未出現,儲存工作後重啟 ComfyUI
- 用 File/Workflow → Open 開 lesson-13-A.json
- 在 Load Diffusion Model 選底模;Load CLIP 選 encoder,type 保持 qwen_image;Load VAE 選 VAE
- 在 LoraLoaderModelOnly/Load LoRA (Model Only) 選 Union 檔案,strength_model 保持 1.0。這個節點只接 MODEL,不需要替 CLIP 接第二條 LoRA 線
應該看到: 17個普通功能節點,模型名稱都可在下拉選單選到。本課不用安裝自訂節點,不需登入或付費API。找不到節點先記錄 ComfyUI 與前端版本,核對是否有官方支援;不要直接安裝同名的陌生套件。
第 2 步:上傳原圖,先認識邊緣路徑
- 在 Load Image 點 choose file to upload/上傳,選 official-input.png
- 如果伺服器自動改名,在節點下拉選單重新選取剛上傳的檔案。JSON記錄檔名,不會代替你上傳
- 沿 IMAGE 線找到 ImageScaleToTotalPixels,保留 lanczos、megapixels=1、resolution_steps=1
- 再找到 Canny/Detect Edges (Canny),low_threshold=0.26、high_threshold=0.35,第一輪先不改
- 確認 Canny 一路連 PreviewImage,一路連 VAEEncode.pixels。彩色原圖先轉邊緣,再轉 latent
應該看到: 上傳節點先顯示彩色原圖。PreviewImage 的黑底邊緣圖要等工作流執行到 Canny 才更新;剛載入JSON時可能是空白,這不是失敗。此處先核對線,下一步再執行。
本節點以 1024×1024 總像素作為 1 MP;1 MP 是目標總像素量,不是強制裁成正方形。這張官方圖本身1024×1024,所以維持正方形;換長方形圖時應保留比例。低門檻可能留下更多細小邊緣,過多紋理未必更好。先完成固定門檻的A/B/C,之後才另開一輪只改Canny。
第 3 步:把同一份 latent 接到三個位置
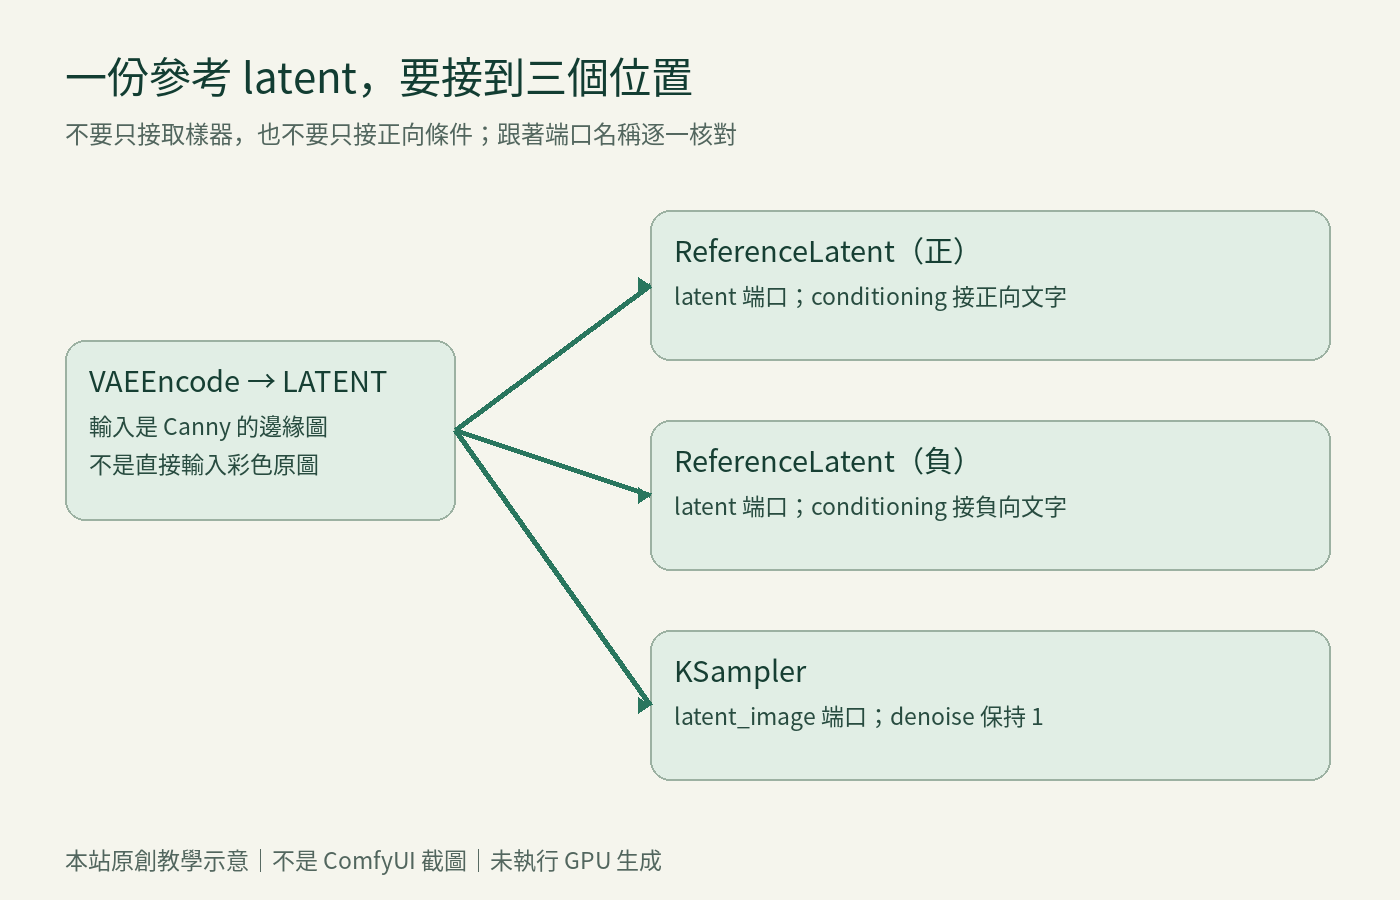
latent 是模型使用的壓縮表示,不是另一張可直接觀看的 PNG。這套 Union 流程不是載入一般 ControlNetLoader;請沿官方設計使用 LoRA 與 ReferenceLatent。
核對 VAEEncode 的 LATENT 輸出同時連到:
- 正向 ReferenceLatent.latent;它的 conditioning 來自正向 CLIPTextEncode
- 負向 ReferenceLatent.latent;它的 conditioning 來自負向 CLIPTextEncode
- KSampler.latent_image
兩個 ReferenceLatent 的輸出再分別接 KSampler.positive 與 negative。VAELoader 同時供應 VAEEncode 和 VAEDecode。不要因為負向文字是空白,就刪掉負向 ReferenceLatent。
第 4 步:跑 A,保存自己的第一張結果
A 保留官方示範的正向長提示詞:白髮人物、黑色花朵、深綠背景與油畫筆觸。負向文字保留空白;第一輪不必重打或翻譯,否則會改變比較條件。先在正向 CLIPTextEncode 節點確認文字,不要把提示詞中的藝術描述誤認成結果保證。
執行前逐項核對:
| 欄位 | 本課固定值 |
|---|---|
| Union strength_model | A=1.0 |
| ModelSamplingAuraFlow | shift=3.1,sampling=flow |
| KSampler seed | 884818889788007 |
| control_after_generate | fixed,不是 randomize |
| steps / cfg | 20 / 2.5 |
| sampler_name / scheduler | euler / simple |
| denoise | 1.0 |
| SaveImage filename_prefix | lesson13/A-strength-1 |
20/2.5從哪來? 官方JSON內的KSampler部分欄位被輸入線覆蓋:enable_turbo_mode=false 時,Switch 選擇20 steps及CFG2.5。不能只看殘留的4 steps/CFG1 widgets;那是另一個加速分支。本站攤平版直接寫入20/2.5,完全移除Lightning分支,避免多下載加速LoRA。
- 按 Run/Queue 一次,等目前工作完成,不要連續點很多次
- 執行到 Canny 後,PreviewImage 應出現輪廓圖;確認有主要人物和花葉輪廓,而不是幾乎全黑或滿版雜線
- 成功後保存 SaveImage 的PNG,再匯出自己的JSON,命名 my-lesson-13-A.json
- 填寫 observations.csv 的 A 列:實際輸入檔名、版本、輸出檔名、輪廓與細節觀察。只有成功完成才填 success
固定seed有助於同一環境比較,仍不保證跨硬體、版本或精度逐像素相同。官方PNG使用此seed,也不能據此承諾你的結果必然與官方檔案一致。
第 5 步:只改 LoRA 強度,完成 B 和 C
最簡單的方式是在剛成功的A畫布直接另存兩份。B把 strength_model改0.5,SaveImage前綴改 lesson13/B-strength-0.5;C改 0,前綴 lesson13/C-strength-0。也可以載入包內B/C,再重新確認輸入圖與模型選擇。
前綴只是為了分開檔案;生成設定只改strength_model。保持原圖、提示詞、seed、Canny門檻、尺寸、步數、CFG、denoise相同。三組都使用同一模型版本,不要中途更新環境。
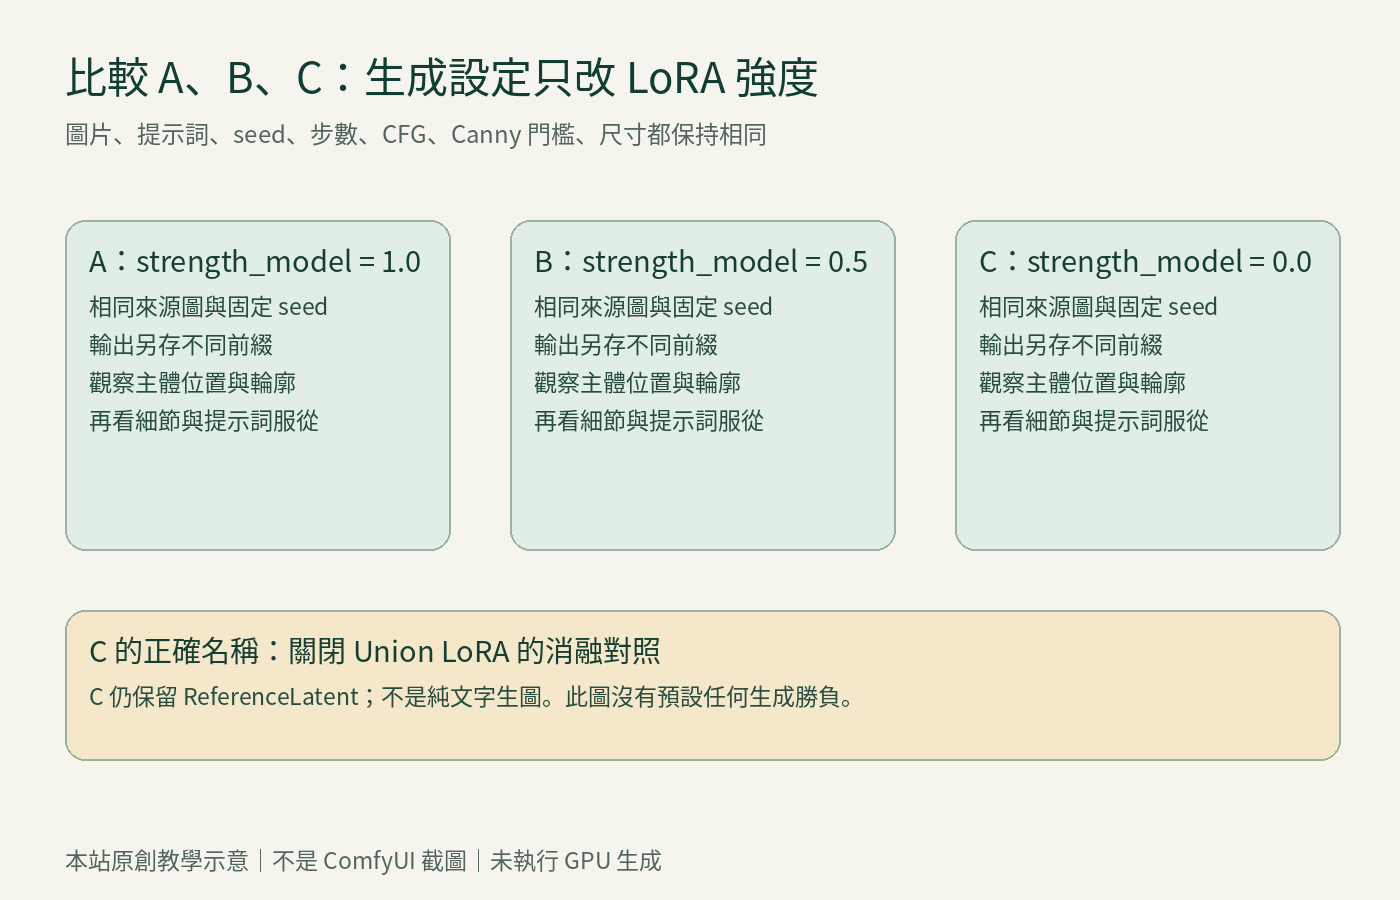
C的正確名稱是「關閉 Union LoRA 的消融對照」:強度0會讓LoRA載入器回傳未套用該LoRA的模型,但兩個ReferenceLatent還在,參考latent也還在。它不是完整移除影像條件的純文字生圖基準,不要用C推論「有圖/沒圖」的差異。
把三張自己的輸出並排,逐項寫下觀察:
- 人物中心、臉部角度、花朵的大位置是否接近輸入?
- 輪廓是否遵循?細節有沒有變得僵硬、碎裂或多出奇怪線條?
- 白髮、黑色衣服和油畫風格是否符合提示詞?
- 更像原圖,是否同時犧牲了你想要的細節?
不預設1最準或0.5最好。三組只比較這張圖與這組設定;不能推廣成所有素材的最佳參數。
常見卡點:先核對哪裡
| 現象 | 先檢查 |
|---|---|
| 模型名稱選不到 | 檔案是否下載完整、資料夾是否正確、是否需要刷新或重啟 |
| 缺少節點或子圖顯示不正常 | 主線請開lesson-13-A.json,不是官方子圖版;確認原生節點和版本,不急著裝套件 |
| 輸入圖拖入後設定變了 | 你可能恢復了PNG的舊workflow;重新開A.json,用Load Image按鈕上傳 |
| 記憶體不足或執行中斷 | 停止排隊,保存錯誤與設備紀錄;31GB不是VRAM保證,不硬套未知低VRAM技巧 |
| Canny預覽全黑或太密 | 先確認輸入;A/B/C主輪保持門檻相同,另存新一輪才調門檻 |
| 畫面不跟輪廓 | 核對Union LoRA檔名與底模、三條latent線,並查看主體輪廓是否清楚 |
| A/B差很多,但seed也不同 | 把control_after_generate改fixed,回到同一seed重做,不以這組當單變因證據 |
完成檢查
- 能說明本課原始Qwen-Image與第九課2.1不能任意互換
- 知道約31GB是磁碟下載量,並記錄自己的環境,不聲稱教材驗證過最低硬體
- 核對17個功能節點與三條latent分支;Canny圖是你實際執行後看到的
- 保存自己的A/B/C PNG、JSON、來源圖和觀察表;未執行的列仍填not_run
- 能說明C不是純文字生圖基準,不把官方範例當作自己的成果
選做:主輪完成後,另存一份工作流,只換成你有權使用的物件照片,從頭固定所有設定再比較。不要一口氣同時換照片、提示詞、seed和強度,否則很難知道變化來自哪裡。
來源、授權與查核版本
- Comfy官方Qwen教學:原生Union Control LoRA流程與官方示範
- 官方固定版本JSON:完整保存於練習包;本站修改為攤平、固定seed、移除加速分支的A/B/C
- 原始素材目錄:input與output中的對應PNG,保留原始bytes與中繼資料,未改像素
- MIT授權:保留Comfy Org著作權與授權聲明;模型權重另依模型頁授權,並未打包
- 核心nodes.py、ReferenceLatent、Canny:核對欄位、LoRA零強度及參考條件行為
- 下載包來源與雜湊清單:官方原圖、JSON與本站原創教學圖的來源記錄
本課是文件、原始碼、素材與工作流結構查核,不是已完成GPU實跑的效能或畫質評測。