COMFYUI 基礎 · 第 01 課
第一次看 ComfyUI:把一張圖的流程讀懂
給完全沒用過 ComfyUI 的新手:用 12 張官方畫面認識工作區、載入第一份工作流、沿線讀懂七個節點,再修改提示詞、匯出與重新開啟。
開始前,準備這些
- 會使用 Windows 檔案總管與下載檔案
- 看圖學習不必安裝;跟著操作需先能開啟 ComfyUI 節點畫面
這一課,你會學會
- 找出提示詞、尺寸與輸出的位置
- 沿著連線說明七個節點的分工
- 完成一份讀圖筆記;已安裝者另存並重新開啟自己的 JSON
本課目錄
這一課先完成什麼
第一次打開 ComfyUI,滿畫面的方塊和線很容易讓人不知道從哪裡開始。我們先只做一件事:找出文字從哪裡進去,圖片從哪裡出來。
你會用官方最簡單的文字生圖範例,認識七個節點。已經裝好 ComfyUI 的人,可以跟著載入、改一段文字、另存,再重新開啟;還沒安裝的人,也能靠本課圖片完成讀圖練習。
本課是讀圖與工作流編輯課,全程不必按 Run,也不需要下載模型、付費帳號或 API 金鑰。 預估 25–35 分鐘,指閱讀與練習時間。本課尚未進行獨立安裝或 GPU 生成實測,不提供硬體相容性或生成速度保證。
學完先留下一份筆記:提示詞在哪裡、尺寸在哪裡、圖會經過哪幾站。後面的 Qwen 圖像與 MiniMax 影片課,會繼續用到這個讀圖習慣。
第 0 步 選你的起點
我還沒安裝 ComfyUI
直接往下看圖即可。先下載本課練習單,用 Windows 記事本開啟,或拿一張紙記錄答案。
若你想接著在電腦操作,課前準備的目標是「能看到圖 1 的節點畫布」。Windows 新手可先讀官方 Comfy Desktop 安裝說明;它有圖形化安裝流程。安裝、驅動與模型下載需要另外安排時間,本課不把它們藏在閱讀時數裡。若手邊已經有 Portable 版本,可沿用現有環境,不需要為了這一課再裝一份。
我已經能開啟 ComfyUI
開啟你現有的 ComfyUI。Desktop 使用者從 Windows 開始功能表啟動 Comfy Desktop,開啟現有安裝;NVIDIA Portable 使用者從自己的官方 Portable 資料夾啟動 run_nvidia_gpu.bat,等它顯示介面。若瀏覽器沒有自動開啟,請使用啟動視窗列出的本機網址;使用期間保留那個啟動視窗。官方 Portable 說明
應該看到: 中央可擺放方塊的工作區。若程式還沒成功啟動,先走看圖路線;不要為了追進度隨意更改驅動或安裝陌生整合包。
第 1 步 先認識畫面上的四個位置
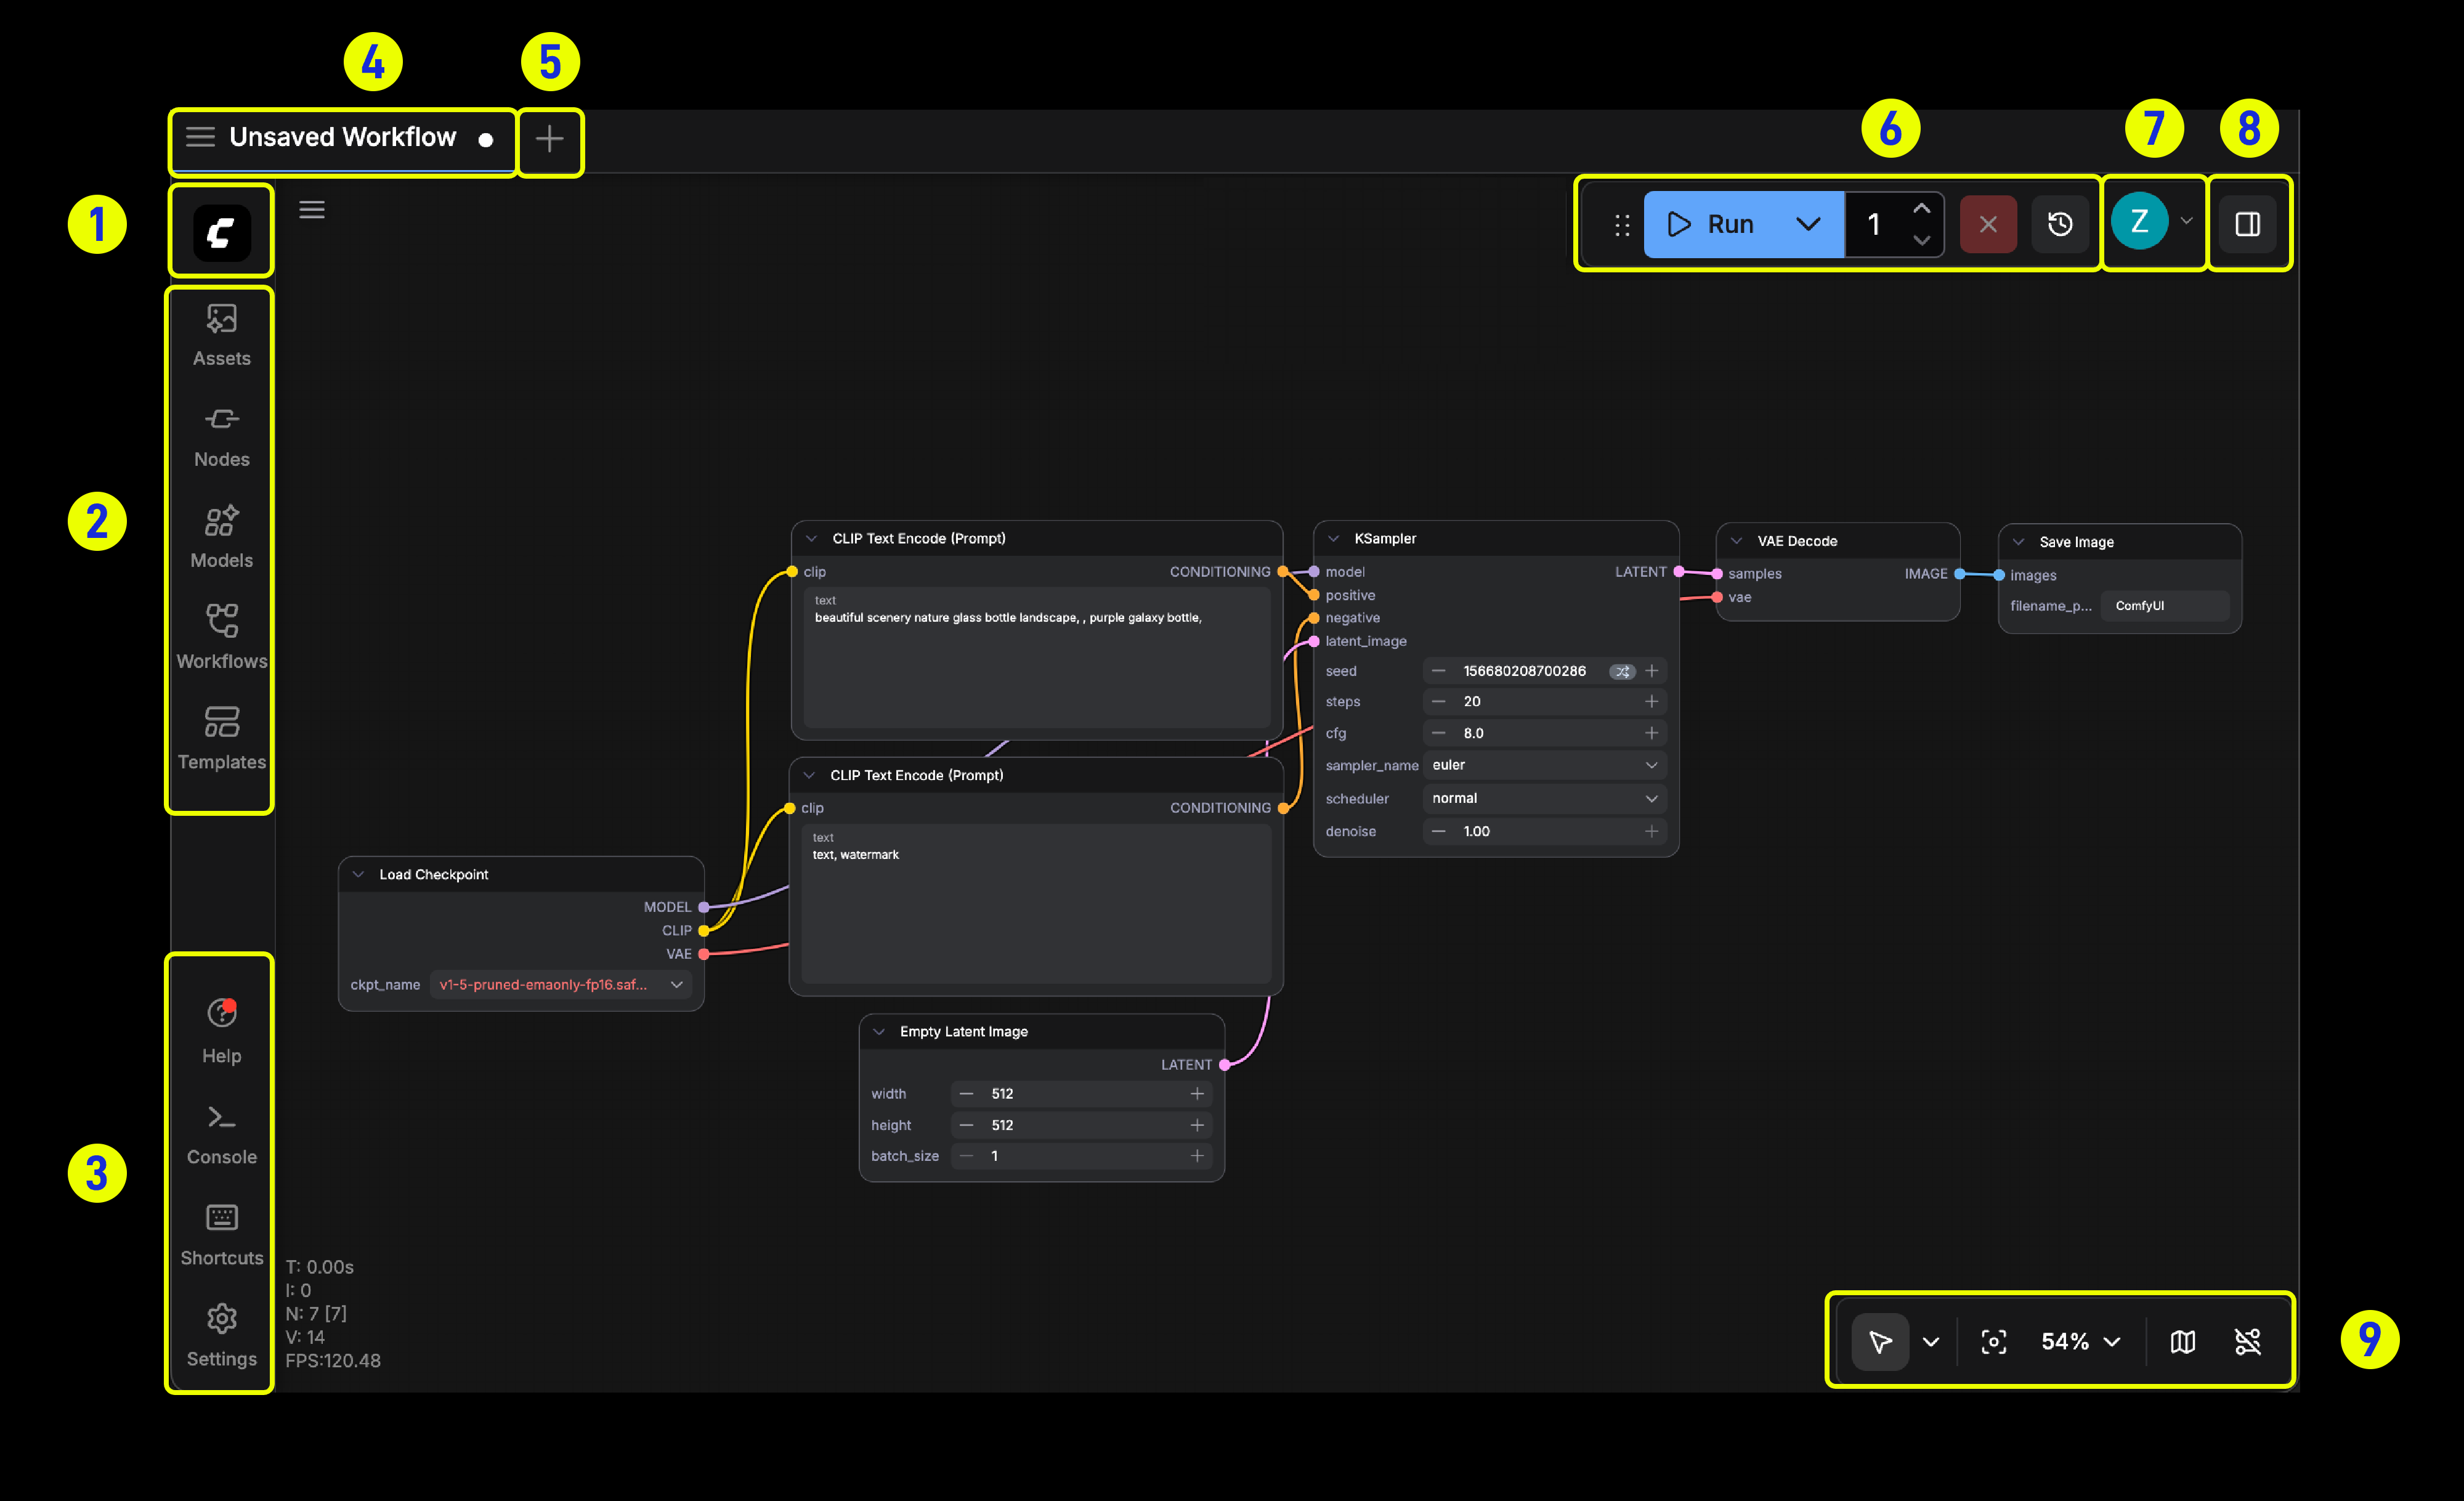
對照圖 1,先找到這四處,不用立刻按任何生成按鈕:
- 左上主選單:開啟與匯出工作流會用到
- 中央畫布:放方塊、拉線的區域;這裡的「畫布」是流程編輯區,不是生成圖片的尺寸
- 右上 Run:執行工作流;今天先認位置
- 右下檢視工具:縮放、將流程移回視野
三個詞先記住:節點(node)是一個有工作要做的方塊;連線(link)把資料送到另一個節點;工作流(workflow)就是這些節點、連線與設定組成的整份流程。官方工作流入門
應該看到: 能指出主選單與 Run,並分得清「方塊」和「方塊之間的線」。如果你的按鈕外觀不同,先對照英文名稱。官方文件中的圖片來自不同介面版本;新版 Nodes 2.0、舊版節點與主題會改變外觀,這一課不必切換版本。Nodes 2.0 官方說明
第 2 步 載入大家都一樣的練習檔
JSON 是用來儲存工作流結構與設定的文字檔,副檔名是 .json。你不用打開它寫程式。
- 下載官方入門工作流 text-to-image.json,先留在 Windows 的「下載」資料夾
- 如果 ComfyUI 裡已有你自己的未儲存作品,先保存那份作品
- 回到 ComfyUI,打開左上主選單,找 Workflow/Workflows → Open,選取剛下載的 JSON。不同介面可能把 Workflow 選單直接放在頂端
- 也可以把 JSON 檔從檔案總管拖到中央畫布;若拖曳沒有載入,改用前一個 Open 方法
- 如果節點太小或偏到畫面外,用右下 Fit View(對齊整個流程的四角框圖示)把它們帶回視野
本課下載檔是 Comfy-Org 官方文件的固定版本,沒有加入額外節點。匯入與匯出的選單用法可對照官方第一張圖教學。
應該看到: 圖 3 那樣的七個節點:一個 Load Checkpoint、兩個 CLIP Text Encode、一個 Empty Latent Image、一個 KSampler、一個 VAE Decode、一個 Save Image。缺模型警告不代表 JSON 沒載入;若出現警告,先看下方「卡住時」一節,再回來讀圖。
順便認識範本入口
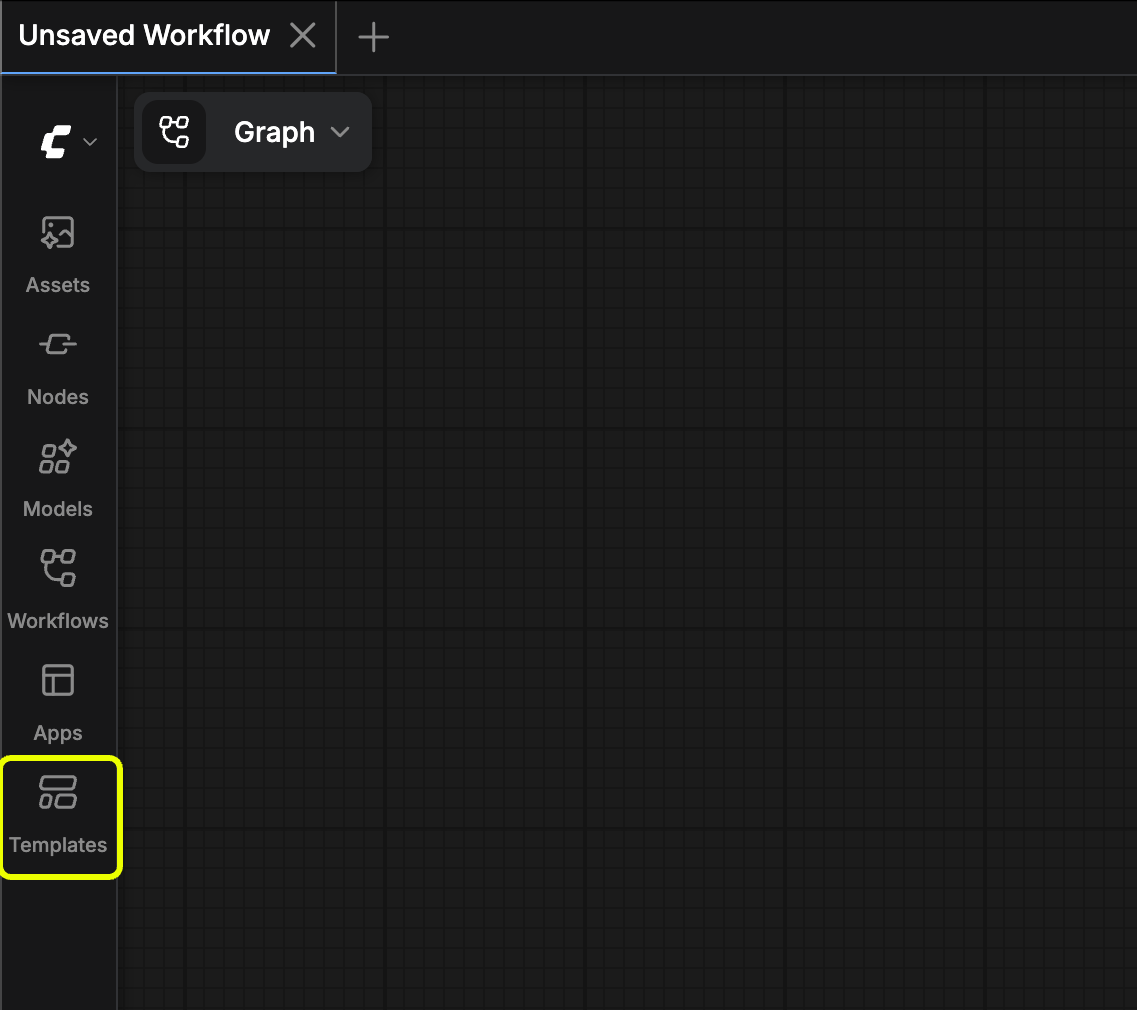
Templates(範本)是官方提供的流程起點,也可能收錄已安裝擴充節點的範例。以後找特定模型時,可以點左側 Templates,或用 Workflow → Browse Workflow Templates。今天用上面的固定 JSON,確保大家看的節點與連線相同;不用另外挑一個新模型。官方範本說明
第 3 步 沿著連線走一遍
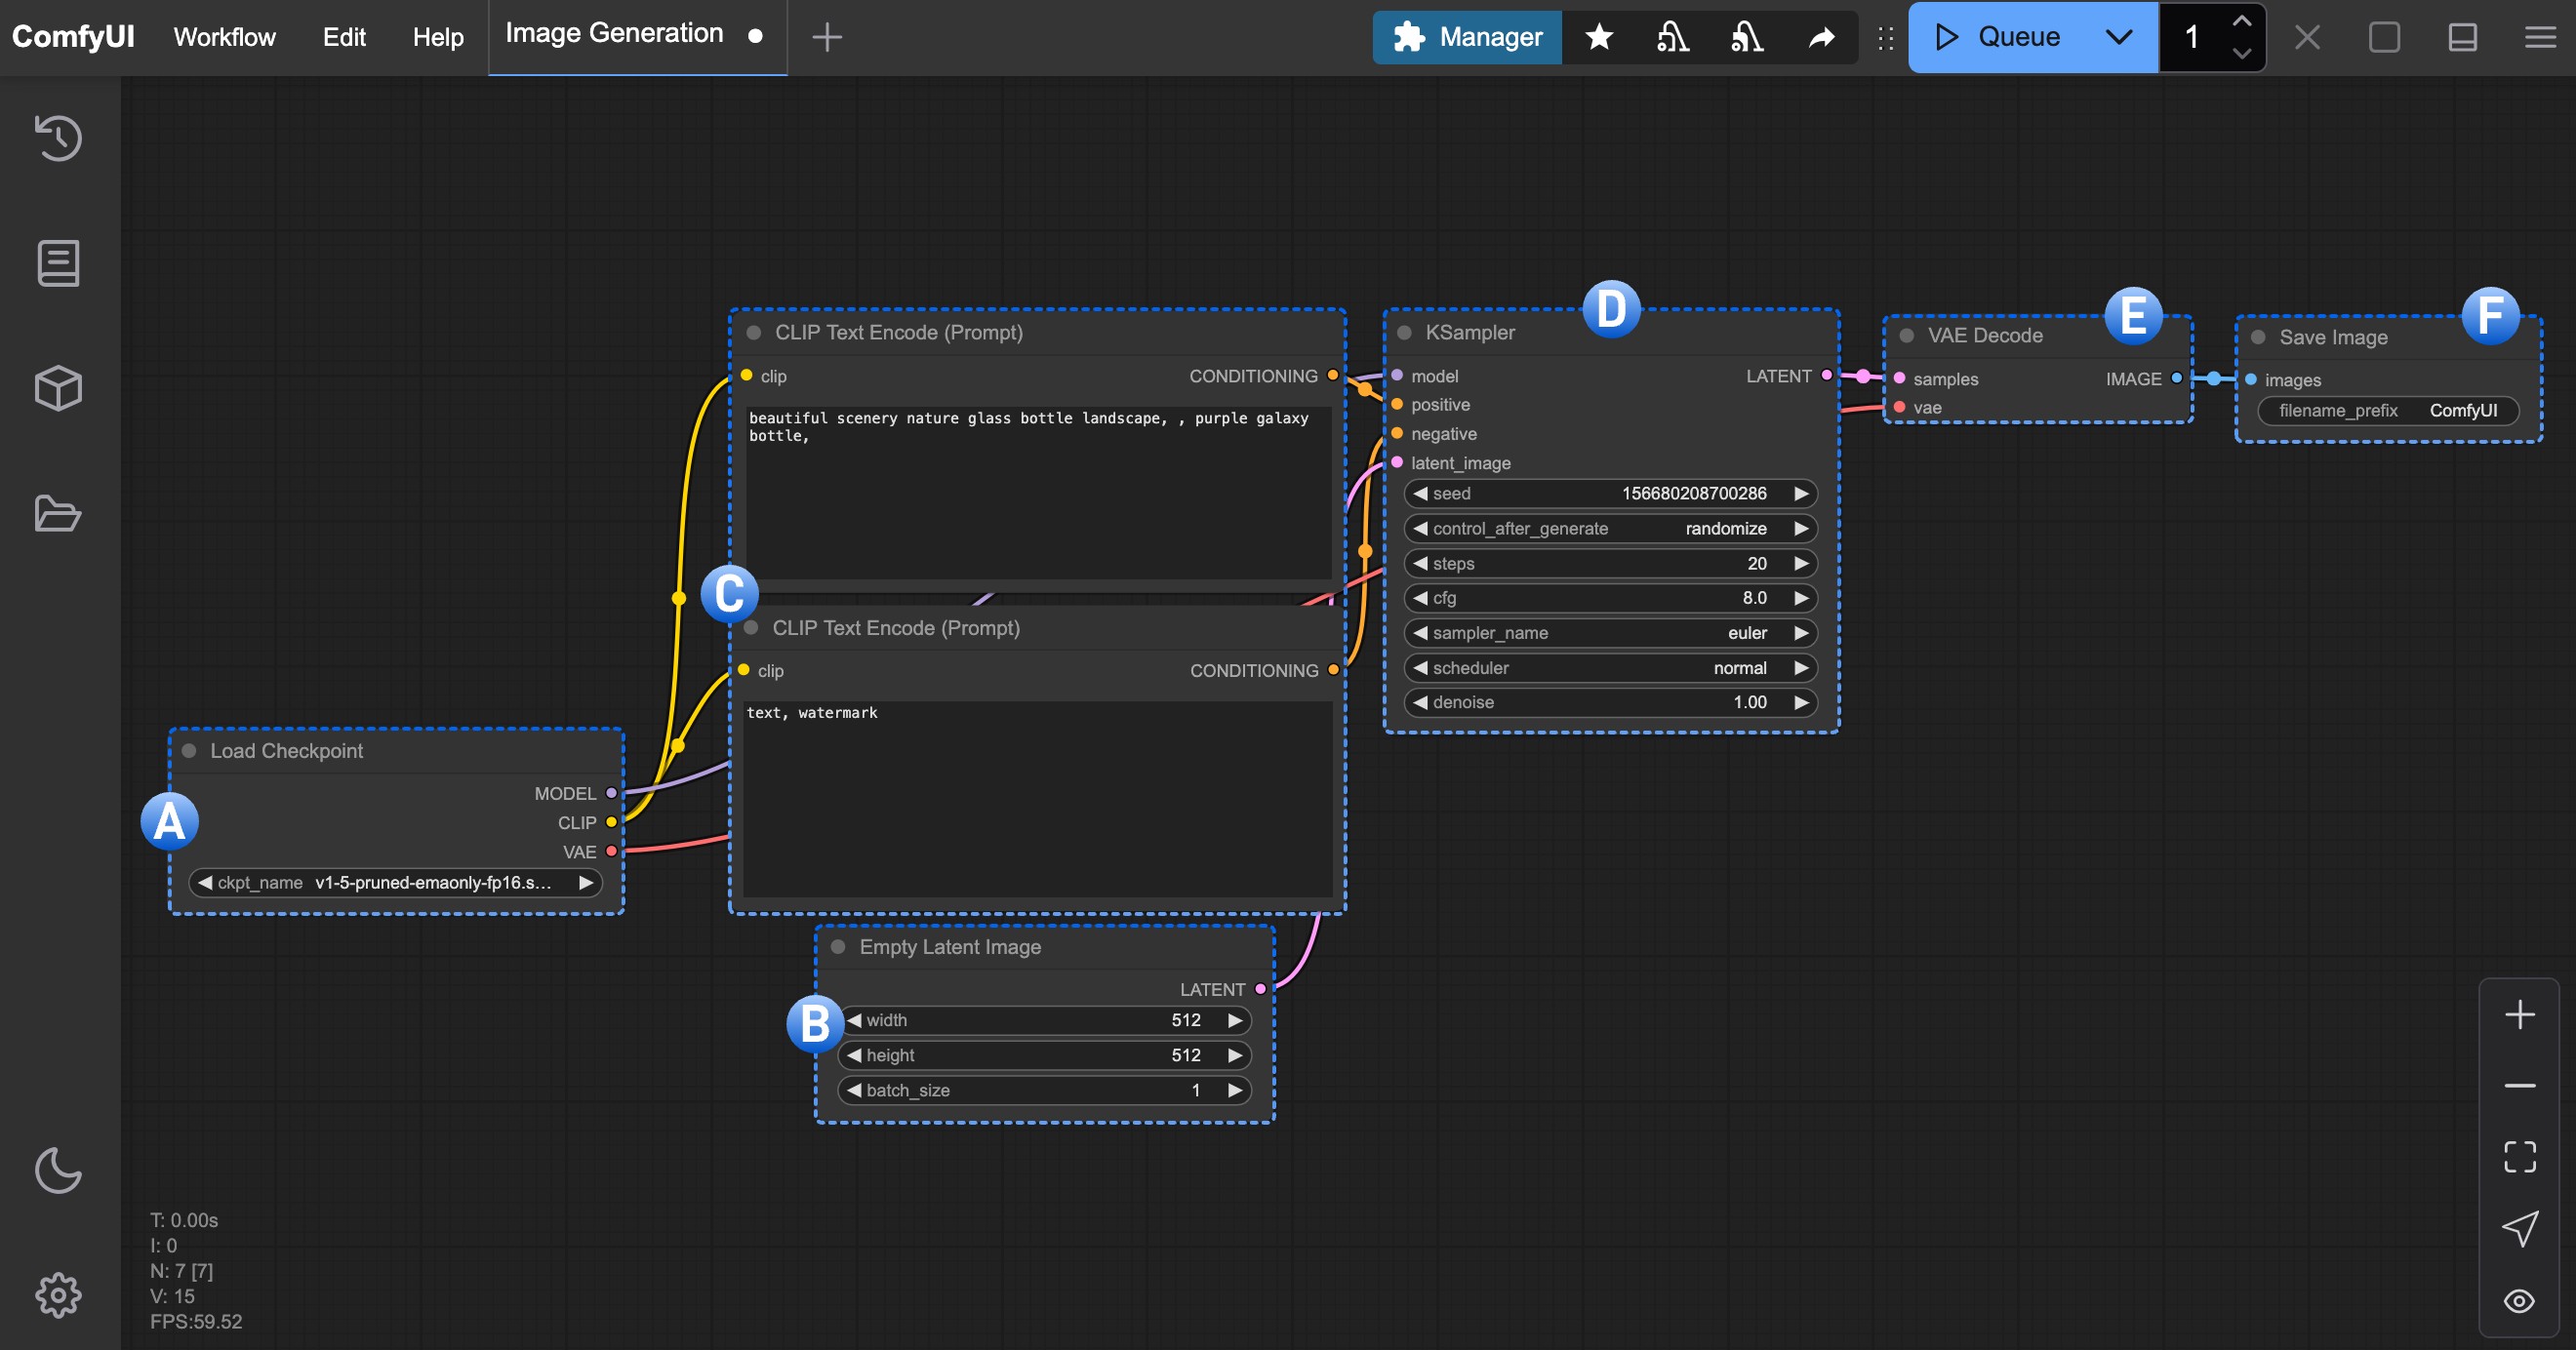
先看全圖,下一步再逐個放大。這份流程有三路資料一起準備:
- A 模型:提供生圖需要的模型元件
- C 文字:把想畫的內容、想減少的內容,轉成模型可使用的條件
- B 尺寸:準備指定寬高的一份空白中間資料
它們在 D 取樣會合,再送到 E 解碼 → F 儲存。
「取樣」可以先理解成根據模型與條件逐步計算畫面;「解碼」是把中間資料轉成真正可觀看的像素影像。今天能說清楚各站工作就夠了,不需要先背所有英文或數學。
跟著做: 用眼睛從 F 往回看,先找 E,再找 D;接著看看 D 左邊分別接到哪三路。連線表示資料依賴,不能只靠方塊擺在左邊或右邊判斷執行順序。連接埠的資料類型必須相容,辨認名稱比只記顏色可靠。官方連線說明
應該知道: 文字不會直接流進 Save Image,中間還要經過編碼、取樣和解碼。
第 4 步 逐個找到七個節點
A 模型從哪裡進來
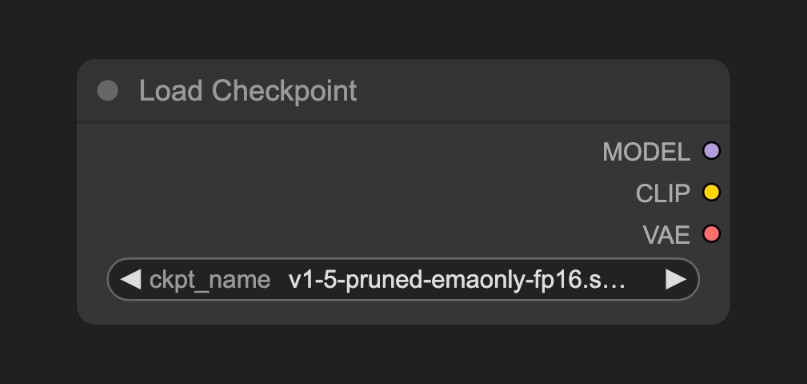
找到 Load Checkpoint(載入模型檔)。下面的 ckpt_name 是檔名欄位;本課 JSON 指定 v1-5-pruned-emaonly-fp16.safetensors。
右邊的三個小圓點,是三種輸出:
- MODEL:提供生成過程要用的模型
- CLIP:提供文字編碼器,把提示詞轉成模型可使用的資料
- VAE:提供影像與中間資料之間的轉換模型
跟著做: 先只讀檔名,再沿 MODEL 的線找到 KSampler。尚未安裝該模型時,欄位可能是紅色或空的,先記錄,不必下載。
應該知道: 在這份 SD1.5 範例,一個 checkpoint 提供上述三個部分。其他模型的工作流可能把它們分開載入,不能看見一個載入器就假設所有模型都一樣。官方載入節點說明
C 文字要寫在哪裡
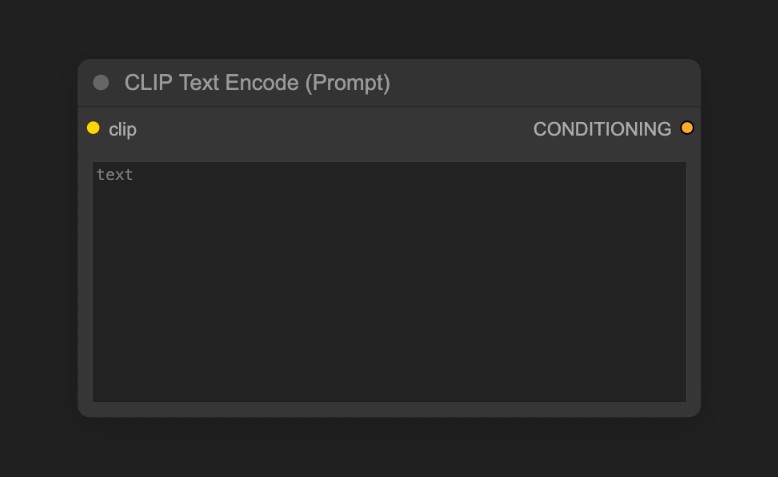
找到兩個 CLIP Text Encode(文字編碼)。中央 text 區域就是提示詞輸入框;右邊的 CONDITIONING(條件資料)是編碼後的輸出。
同樣的節點出現兩次,是因為它們接到不同的地方:
- 接到 KSampler 的 positive:描述想要的畫面
- 接到 KSampler 的 negative:描述希望減少的內容;它不是百分之百排除某物的保證
跟著做: 看圖 3,上方文字框原本提到 scenery、glass bottle;沿它的線確認接到 positive。下方文字框是 text, watermark,接到 negative。位置可以被搬動,請以連線判斷。官方文字編碼節點說明
應該知道: 若想換主角,先找連到 positive 的文字框。
B 圖片尺寸在哪裡
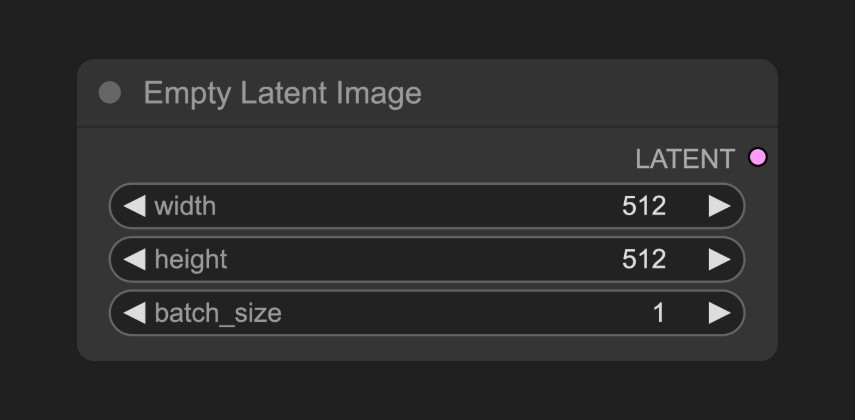
找到 Empty Latent Image。latent 是模型運算時使用的中間資料,還不是可直接存成 PNG 的像素圖片。
- width:圖片寬度,本課檔案是 512
- height:圖片高度,本課檔案是 512
- batch_size:一批處理的張數,本課是 1
跟著做: 確認這三個數字,今天保持不變。
這個節點先建立指定尺寸的空白 latent;在本課這種流程中,KSampler 會再依 seed 準備隨機雜訊。不要把這個方塊想成已經畫好的一張黑圖,也不需要手動做一張雪花雜訊圖。官方 Empty Latent Image 說明 · v0.38.0 實作
D 哪一站負責取樣
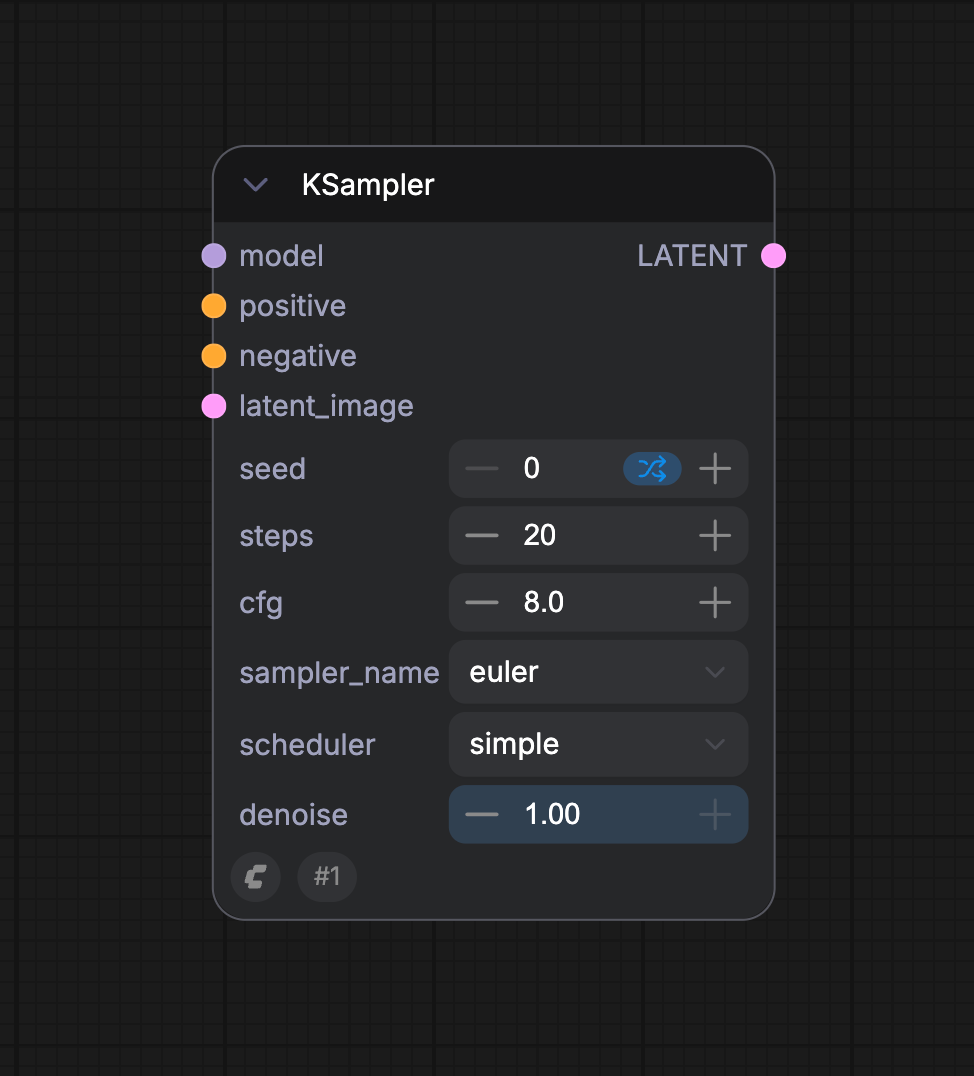
找到 KSampler。看左側四個輸入:model、positive、negative、latent_image。右側輸出仍然是 LATENT。
這次只認三個設定,先不要調整:
- seed(隨機種子):決定準備雜訊時使用的隨機起點
- steps(步數):取樣計算的步數,不能直接當作「畫質分數」
- cfg(引導強度):這類流程中控制文字條件的引導程度,不是越高越好
跟著做: 在自己的工作流找出 seed 和 steps。固定版 JSON 的 steps 是 20、cfg 是 8、sampler_name 是 euler、scheduler 是 normal;只核對,不把單一節點示意圖的其他數值抄進來。
應該知道: KSampler 的輸出還要解碼。往後要做受控比較時,還得固定模型、設定、軟體環境與 seed;只記一個 seed 不足以保證跨版本逐像素重現。官方 KSampler 說明 · PyTorch 重現性說明
E 中間資料怎麼變成圖片
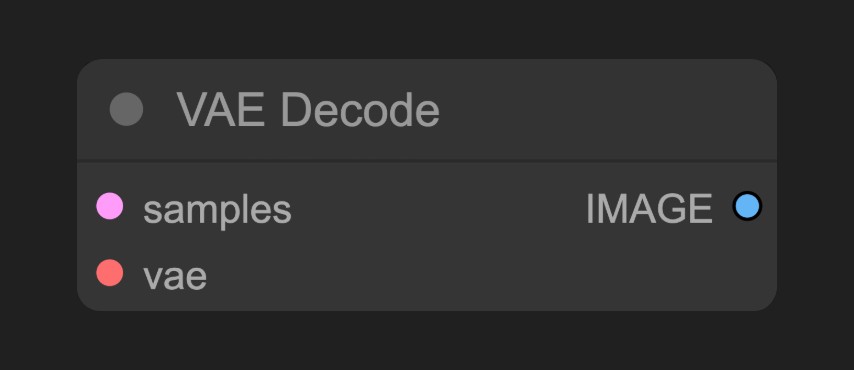
找到 VAE Decode(解碼)。左側 samples 接 KSampler 的 LATENT;另一個 vae 輸入接 Load Checkpoint 提供的 VAE。它把中間資料轉成右側的 IMAGE(像素影像)。
跟著做: 找到這兩條輸入線,以及往 Save Image 的輸出線。今天不用拔線重接。官方 VAE Decode 說明
F 圖片最後存在哪一站
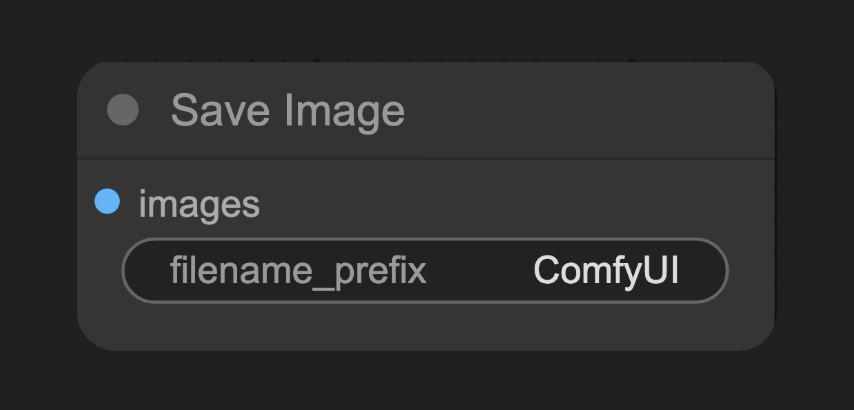
找到 Save Image(儲存圖片)。它接收 IMAGE,filename_prefix 是輸出檔名的前綴;本課原始值是 ComfyUI。實際執行成功時,內建節點會把圖片存到所設定的輸出資料夾,一般本機配置使用 ComfyUI/output。官方 Save Image 說明
應該知道: 今天沒有執行生成,所以節點裡沒有成品預覽是正常的。Save Image 負責存圖片;下一步的 Export 則是保存整份工作流 JSON,兩件事要分開記住。
第 5 步 改一段文字 然後把流程帶走
我們先替後續課程準備同一個主角:綠色小豆機器人、黃色背包、黑色圓眼。這三個特徵寫進練習單,之後做圖、修改與影片都沿用。
已經開啟 ComfyUI 的人,照著做:
- 回到圖 5 的文字框,沿線確認你選的是接到 positive 的那一個
- 在框內選取原文字,換成下面這一段練習提示詞
- 點畫布空白處,確認文字仍在;尺寸、seed 與其他設定都先保留
- 打開主選單的 Workflow/Workflows → Export,匯出一般工作流 JSON;這次不要選給程式使用的 API 格式
- 把檔案命名為 greenbean-lesson-01.json,在自己的「文件」內新建 Greenbean-Learning 資料夾,將檔案移進去
- 再用 Open 載入你剛匯出的檔案,確認七個節點、連線和新提示詞都在
練習提示詞:
一個圓潤的綠色小豆機器人,黃色背包,黑色圓眼,站在木桌旁;桌上只有一盞白色小桌燈,柔和晨光,淺灰背景,完整呈現主角與桌燈,簡潔 3D 插畫。
這段文字先用來練習「修改後有沒有保存」。本課沒有對 SD1.5 的中文理解或出圖品質做驗證;之後會按實際使用的模型調整提示詞。
應該看到: 重新開啟後,positive 文字框中仍有「綠色小豆機器人」。只截圖無法取代這份可重新載入的 JSON。官方工作流保存說明
還沒安裝的人,把提示詞與七個節點名稱記在練習單即可;「重新開啟 JSON」先留待環境準備好再完成,不需要假裝已經做過。
卡住時 先分清楚少了什麼
出現 Missing Models
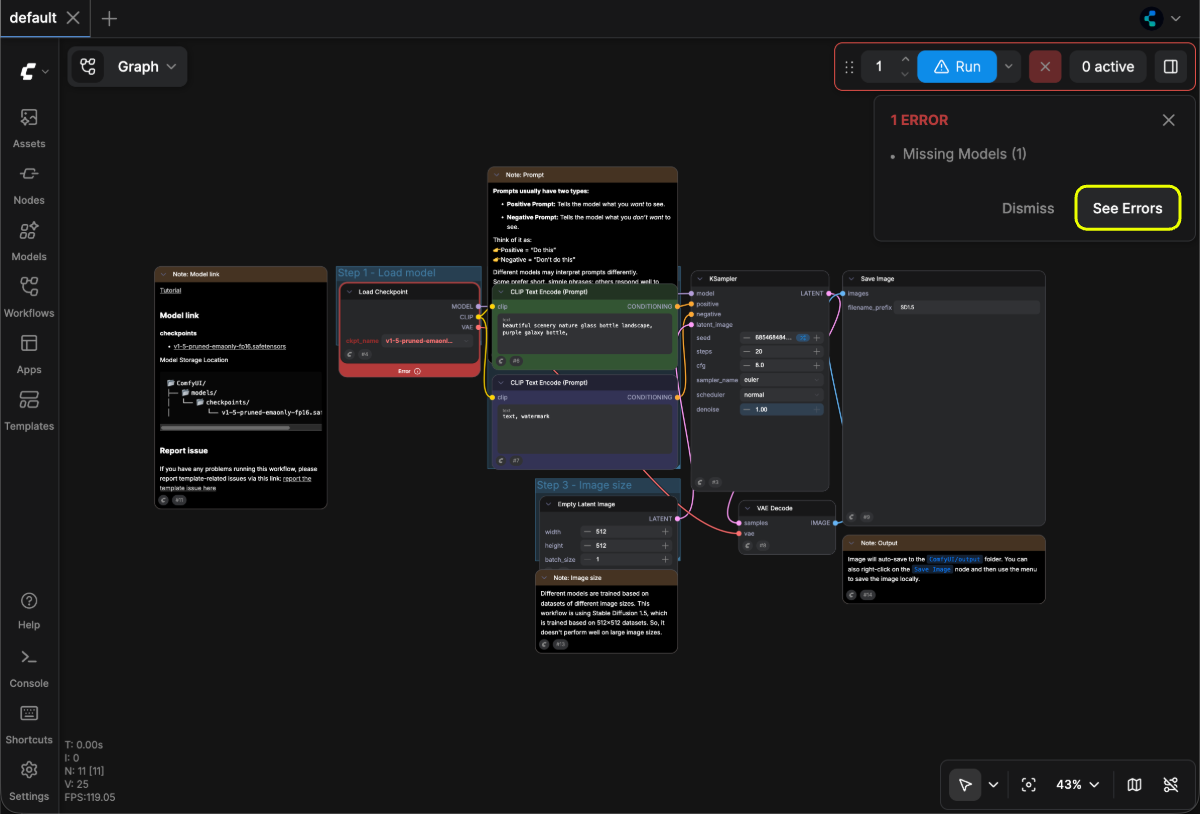
這是缺模型檔案的提示。若畫面像圖 10,按 See Errors,看它列出的檔名。
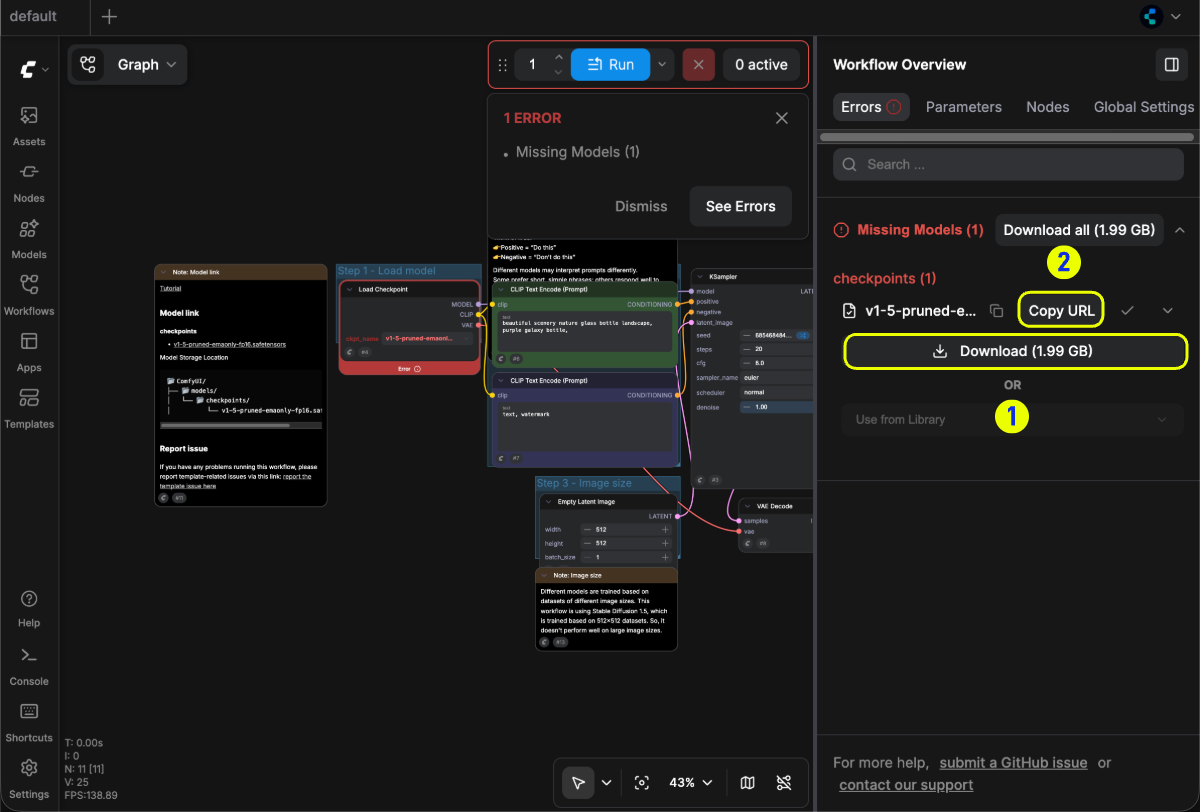
在圖 11,checkpoints 是模型檔案分類。把完整檔名寫進練習單,再關閉詳細資訊,繼續讀圖。本課沒有生成任務,所以不用急著按 Download all。不同版本的缺檔視窗可能長得不同;關鍵是先辨認「模型檔案」這一類。官方缺模型說明
出現 Missing Nodes 或紅色方塊
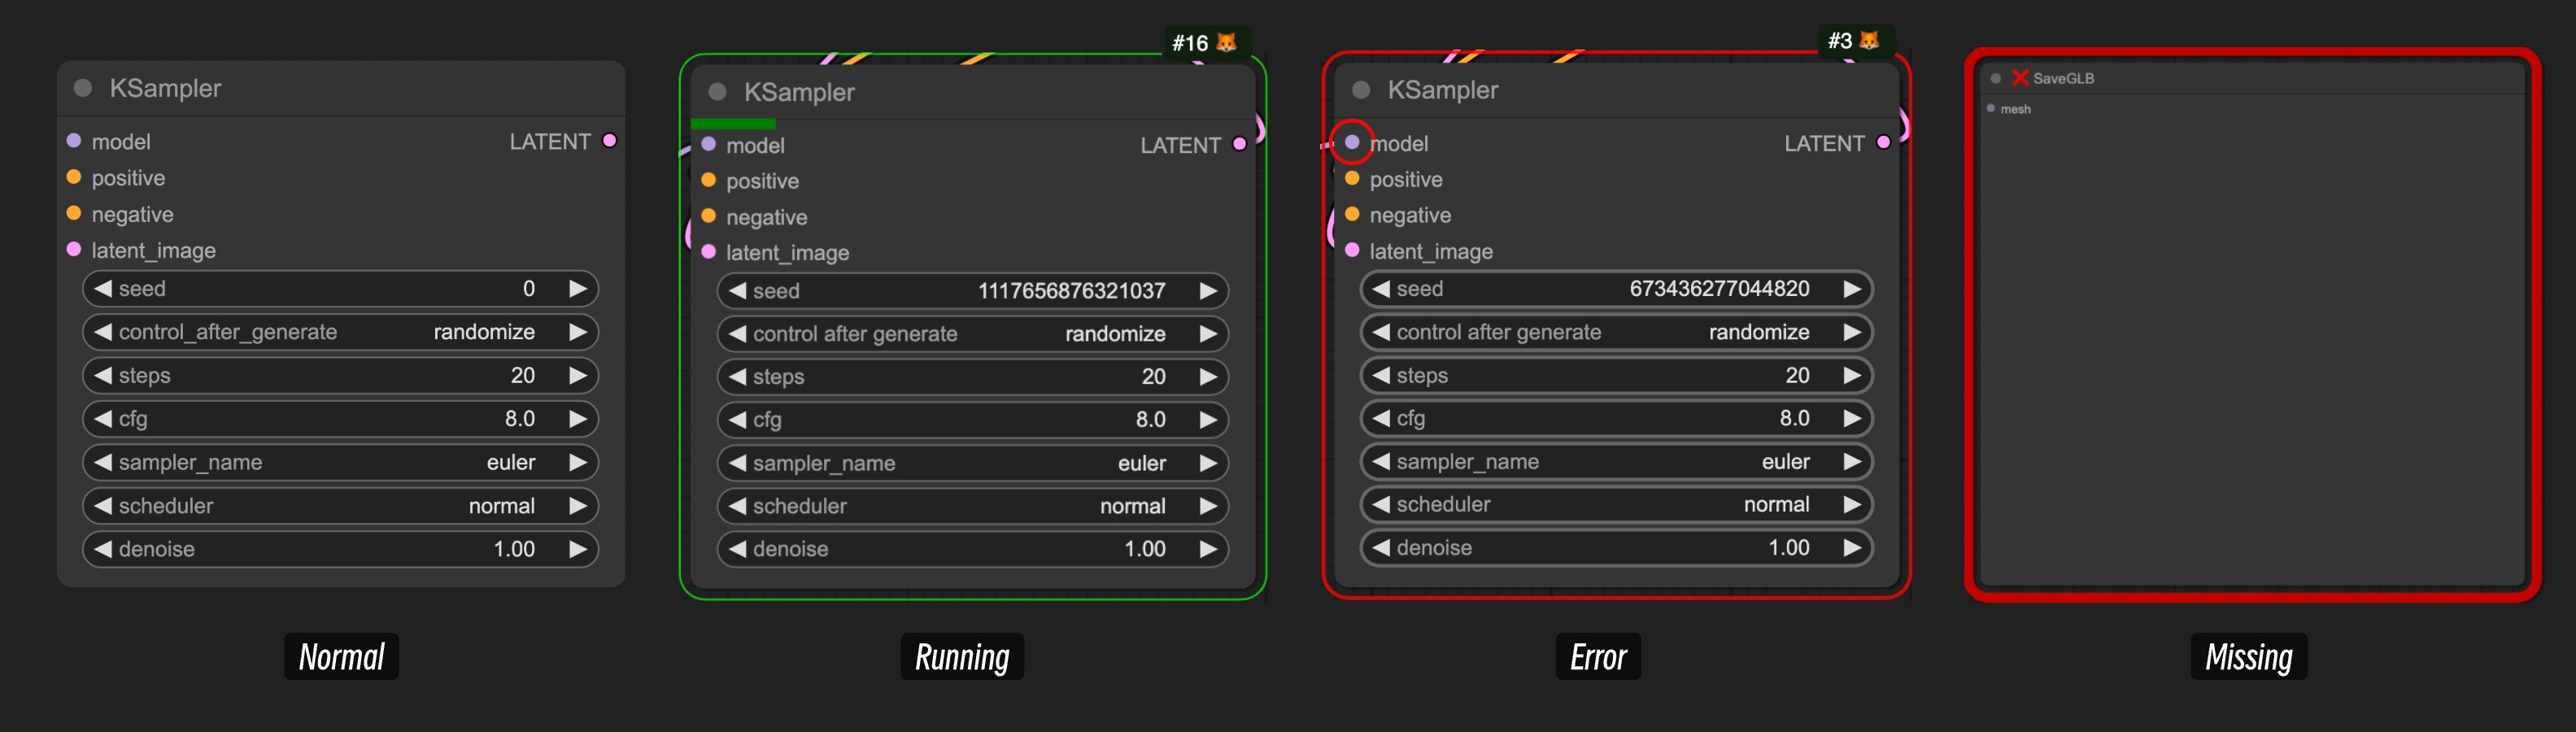
缺節點表示某一種處理步驟無法被目前環境辨識;缺模型則是已有處理步驟,卻找不到它要讀的模型檔。下載一個模型檔,不能自動補出缺少的節點。
如果載入本課固定 JSON 就缺節點,先記下錯誤文字、節點名稱與你的 ComfyUI 版本。本課使用的是內建節點,不需要先去安裝一串陌生的 custom nodes(第三方擴充節點)。紅框也可能表示輸入錯誤,請讀訊息後再處理。官方節點狀態說明
另外三個新手常遇到的狀況
- 下載後變成網頁,或看見一整頁大括號:你可能開到了 JSON 預覽。使用本頁下載連結,確認檔案副檔名是 .json;不要把 HTML 網頁只改名成 JSON
- 所有節點突然不見:先用右下 Fit View 找回視野,不要急著重新安裝;如果本來就在看圖路線,請直接對照圖 3
- Save Image 沒有新圖片:本課不執行生成,這是預期狀態;完成標準是讀懂與保存流程,不是出圖張數
小練習 你真的找得到嗎
先看圖 3 回答,再往下核對。每題只寫一句話就好。
- 想把「綠色機器人」改成「藍色機器人」,先改哪裡?
- 想知道這份範例是正方形還是長方形,要看哪兩個欄位?
- 從 KSampler 輸出的資料,能不能直接接到 Save Image?中間需要哪個節點?
- 朋友只給你一份 JSON,你就一定擁有生成需要的模型檔嗎?
- 這份範例有 A–F 六個區域,為什麼數起來是七個節點?
參考答案
- 改接到 KSampler positive 的 CLIP Text Encode 文字框;不要改到 negative
- 看 Empty Latent Image 的 width 與 height;本課都是 512,所以是正方形
- 不可以,LATENT 與 IMAGE 是不同資料類型;先經 VAE Decode 轉成 IMAGE
- 沒有。JSON 記錄流程、檔名與設定,模型檔仍須另外準備
- C 區有兩個文字編碼節點,一個接 positive,一個接 negative
本課完成檢查
- 我能在圖上指出文字輸入、圖片尺寸和圖片輸出的位置
- 我能說出取樣後還要解碼,才能得到像素影像
- 我知道 JSON、模型檔、生成圖片是不同的檔案
- 我已把小豆機器人的三個固定特徵寫進練習單
- 若已有 ComfyUI,我已匯出並重新載入 greenbean-lesson-01.json;若尚未安裝,這一項記為「待操作」
下一課會接著做什麼
接著閱讀第 02 課:準備執行環境與模型檔案。從 Windows 環境準備開始,沿用今天的 JSON 和缺檔筆記,核對模型檔名、來源與資料夾,再依官方文件完成第一次生成與保存。先看第二課的環境條件;不符合時可先完成看圖與準備紀錄。
往後進入 Qwen-Image-2.1,會換用它對應的官方工作流,不會把這份 SD1.5 的數字整套搬過去。MiniMax H3 也會有自己的模型、輸入與驗證步驟。先把今天的「沿著線找資料」學會,下一次看到更大的流程就有起點。Qwen-Image-2.1 官方範例
版本與圖片來源
查核日期:2026 年 10 月 5 日。當日官方最新穩定核心版本為 ComfyUI v0.38.0。Desktop 啟動器、ComfyUI 核心、前端介面與範本套件各有版本;這裡的核心版本不是整套電腦的實測組合。
本課 12 張圖片均取自 Comfy-Org 官方文件,保留原圖與既有標示,未重畫或合成操作畫面,也不是本網站在你的電腦上拍攝的紀錄。部分圖片是舊介面,部分是新版節點;逐圖圖說已說明重要差異。官方圖片沒有公開每張截圖的完整軟體版本,因此不宣稱全部拍攝於 v0.38.0。
圖片與官方入門 JSON 固定取自 Comfy-Org/docs 版本 fd96fce。該來源庫的 GPL-3.0 授權原文隨教材保留;每張圖下方另附原文件連結。模型權重、第三方素材與生成成果的使用條件需要分別核對,本課沒有作出商業使用權承諾。