LFM2.5-24B-A2B 開放:用本機模型跑 Hermes 晨報,先看官方示範與成本限制
Liquid AI 10 月 13 日推出 24B、每次啟用 2B 參數的推理模型。官方影片展示 Hermes 查找模型、整理晨報與追問;整理試用入口、本機部署重點,以及 API 與授權條件。
本文導覽
每天想整理新模型清單,還想接著追問其中一款,工作不只是一問一答:代理得找資料、叫工具,再把結果整理好。Liquid AI 於 2026 年 10 月 13 日推出 LFM2.5-24B-A2B,主打讓這類流程使用本機推論。它有 24B 總參數,每個 token 啟用約 2B,不能把它當成只需載入 2B 權重的小模型。
想先體驗可前往 Liquid Playground:https://playground.liquid.ai/chat?model=LFM2.5-24B-A2B ,目前會要求登入。官方示範與公告:https://www.liquid.ai/blog/lfm2-5-24b-a2b 。準備本機部署再看指南:https://docs.liquid.ai/examples/agent-harnesses 。本文核對官方資料與素材,未登入、安裝模型或實測速度。
先看官方示範:晨報之後,還能接著追問
影片中可見 Hugging Face 熱門模型摘要,接著有人追問 Liquid AI 的 d1-3B,Hermes 顯示工具執行,聊天端接續回答。值得觀察的是工作流程如何銜接,不是把示範中的每項模型介紹當成獨立查證過的新聞。這也不保證任意提示都能一次成功。
新版的改變,以及官方速度數字怎麼看
官方把它定位為會先推理再回答的模型,上下文由前代 32,768 擴至 131,072 token。發布時列有 llama.cpp、MLX、vLLM、SGLang 與 ONNX 支援;相容不等於每台電腦都能以同樣記憶體與速度執行。
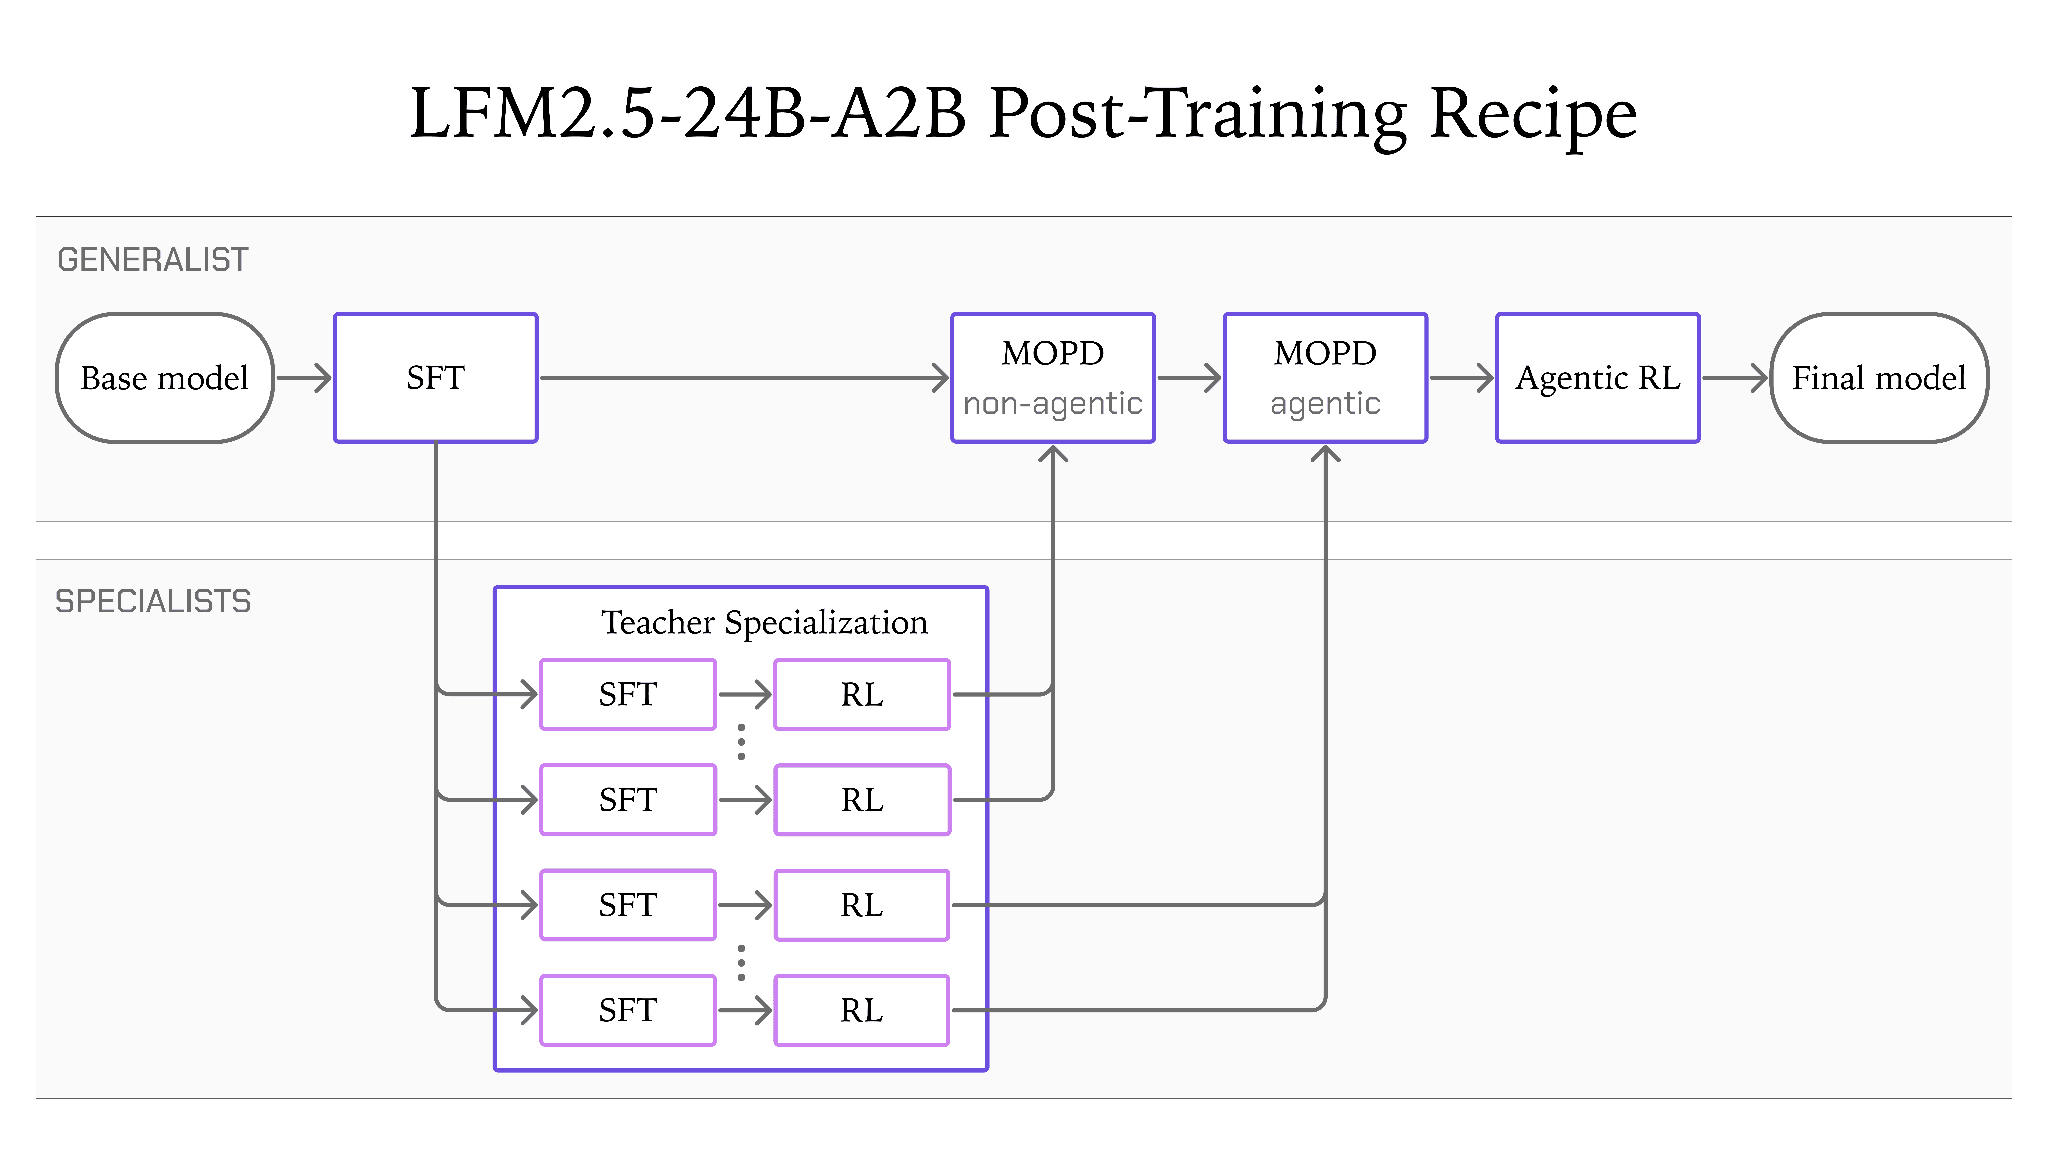
官方報告 M5 Max 解碼 184 token/秒,另列 B300 高併發總輸出超過 21,000 token/秒。後者是多請求吞吐量,不能當作單人聊天速度,也不能直接拿來替自己的顯示卡排名;本文沒有進行同條件比較。
本機部署先分清模型、工具與連線
- 官方指南的基本做法是先啟動支援工具呼叫的 OpenAI 相容本機端點,再讓 Hermes 等代理連到它。
- 指南大部分指令與容量表使用 LFM2.5-2.6B;其中 Q4_K_M 的 1.67GB 不是這款 24B 模型的容量。替換模型名稱後,也必須重新評估量化、記憶體與上下文。
- 模型留在本機不代表整個代理完全離線。網頁查詢、Telegram 或其他外部工具仍有各自的資料流向,敏感資料送出前要另外確認。
API 另計費,開放權重也有授權條件
官方公告列 API 每百萬輸入 token US$0.10、快取輸入 US$0.05、輸出 US$1.00,並提到新註冊 Console 帳號的 US$2 起始額度。本機執行則要負擔硬體、電力與維護成本,不能視為所有用途零成本;本文未驗證台灣付款、帳號額度或繁中品質。
LFM Open License 不是原封不動的 Apache 2.0,含年營收 US$1,000 萬門檻與商用限制。企業用途應直接閱讀完整授權並確認適用條件,不要因為能下載權重就推定毫無限制。
適合的第一個小測試,是整理一小份公開資料,再追問其中一項並核對來源。先確認工具有真正執行、回答與資料一致,再擴大任務;不必一開始就要求代理處理重要帳號或大量私人文件。